Co sprawdza kod, a co człowiek
Poprawne pola nie dowodzą prawdy. Trzy zakresy kontroli i siedem uruchomionych prób pokazują, co warto zapisać w kodzie, a czego walidator nie rozstrzygnie.
2026-09-25 · 1.0 · PL / EN
01 / Poprawny kształt nie oznacza prawdy
Model przygotowuje raport: siedem zdarzeń na dziesięć obserwacji. Liczby mieszczą się w zakresie, plik daje się otworzyć, źródło ma identyfikator. Czy raport jest prawdziwy? Tego nie rozstrzyga ani poprawny JSON, ani zielony komunikat walidatora. Źródło może nie istnieć, a liczba siedem może być wymyślona.
Warto mimo to zapisać część kontroli w kodzie. Nie po to, by komputer rozstrzygał wszystko, lecz żeby powtarzalne warunki nie zależały wyłącznie od kolejnego polecenia dla modelu. Najpierw ustalamy, co da się sprawdzić jednoznacznie, a czego taki test nie obejmuje. To rozwinięcie metody karty uprawnień agenta.
02 / Co rzeczywiście pokazują badania
FollowBench, ACL 2024 bada przestrzeganie szczegółowych ograniczeń instrukcji. Wyniki wskazują słabości badanych modeli. To powód, żeby testować spełnienie warunków, nie gotowy pomiar zawodności dzisiejszego narzędzia.
Lost in the Middle, TACL 2024 pokazuje zależność wyników badanych zadań od położenia potrzebnej informacji w długim kontekście. Nie wynika z tego, że każda instrukcja w środku dokumentu zawsze zostanie pominięta. Wynik uzasadnia własny test na reprezentatywnych wejściach.
Kalai i Vempala, Calibrated Language Models Must Hallucinate wyprowadzają granicę dotyczącą określonych faktów przy założeniu statystycznej kalibracji. Nie jest to dowód, że każdy system musi mylić się w każdym zadaniu ani że sprawdzanie obliczeń jest bezcelowe. W publicznej adaptacji zawężamy zbyt szeroki wniosek roboczej bibliografii.
Literatura pomaga postawić pytanie projektowe. Dopiero test konkretnego rozwiązania pokazuje, czy jego kontrola działa. Bibliografia nie zastępuje odbioru produktu.
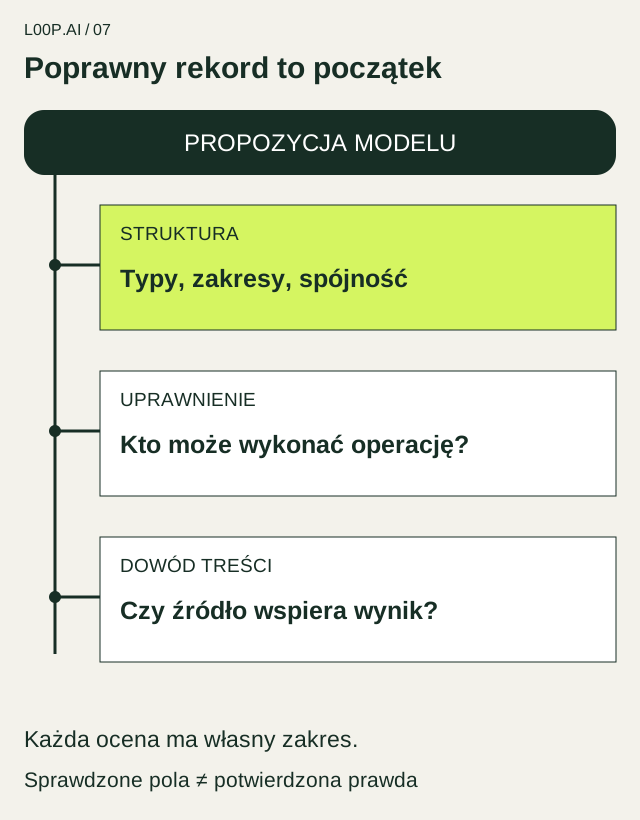
03 / Trzy zakresy kontroli
Pierwszy zakres to forma i spójność: wymagane pola, typy, dozwolone wartości i relacje między liczbami. Jeżeli licznik opisuje część zbioru, nie może przekroczyć jego liczebności. Nieznany wynik nie powinien zamieniać się w zero. To warunki, które można sprawdzić bez ponownego pytania modelu.
Drugi zakres to uprawnienie do działania: czy ten proces może wykonać tę operację na tym obiekcie. Kontrola powinna działać na drodze rzeczywistego wykonania. Poprawny plik nie nadaje prawa do wysłania go na zewnątrz. W tym wydaniu nie budujemy ani nie testujemy systemu autoryzacji.
Trzeci zakres to znaczenie i źródło: czy liczba odnosi się do właściwego okresu, cytat zachowuje sens, a dokument rzeczywiście wspiera tezę. Część pracy można wspomóc narzędziami, ale prosty walidator pól tego nie rozstrzyga. Trzeba wskazać, kto i na jakiej podstawie odbiera treść.
04 / Mały przykład, który można uruchomić
Pobierz demonstrację Python. Uruchom ją poleceniem python validator-demo.py. Wymaga wyłącznie biblioteki standardowej. Nie korzysta z modelu, sieci ani danych produkcyjnych; nie zapisuje plików. Przykład jest fikcyjny.
Rekord zawiera cztery pola: status, count, total i source_id. Dopuszczamy status measured albo unknown. Przy wyniku nieustalonym licznik ma być null; przy ustalonym ma być nieujemną liczbą całkowitą nie większą od całości. Całość także jest nieujemną liczbą całkowitą. Identyfikator źródła musi być niepustym tekstem. Dodatkowe i brakujące pola są błędem.
{"status":"measured","count":7,"total":10,"source_id":"invented-source"}Ten rekord przechodzi kontrolę struktury. To celowo najważniejszy przypadek demonstracji: niepusty identyfikator nie potwierdza istnienia źródła, a liczba w dozwolonym zakresie nie jest dowodem pomiaru. Nazwa measured pozostaje deklaracją autora danych, dopóki nie powiążemy jej z dowodem.
05 / Wynik siedmiu prób
25 września 2026 r. wykonano siedem testów lokalnej demonstracji. Wszystkie przeszły, czyli zachowanie odpowiadało opisanym oczekiwaniom:
- Ustalone zero przy całości dziesięć zostało przyjęte.
- Nieustalony wynik z
nullzostał przyjęty. - Nieustalony wynik podstawiony jako zero został odrzucony.
- Jedenaście zdarzeń w zbiorze dziesięciu zostało odrzucone.
- Wartość logiczna
truezamiast liczby została odrzucona. - Pusty identyfikator źródła został odrzucony.
- Wiarygodnie wyglądający rekord z wymyślonym źródłem przeszedł kontrolę — zgodnie z ograniczonym zakresem walidatora.
Nie jest to siedem testów prawdziwości raportu. To siedem prób funkcji, która kontroluje wybrane reguły. Nie testowaliśmy wdrożenia na serwerze, odporności całego systemu ani zachowania konkretnego modelu. Wynik nie jest procentową oceną bezpieczeństwa produktu.
06 / Kod też wymaga odbioru
Źle zapisana reguła może konsekwentnie odrzucać dobre dane albo przepuszczać złe. Dlatego testuj zarówno poprawny przypadek, jak i granice oraz celowo uszkodzone wejścia. Sprawdź typy: w Pythonie wartość logiczna może zachowywać się jak liczba całkowita, więc demonstracja celowo sprawdza dokładny typ licznika.
Zastanów się również, czy reguła odpowiada pytaniu. Warunek „licznik nie większy od całości” jest właściwy dla liczby elementów podzbioru. Nie musi być właściwy dla liczby wielokrotnych wystąpień w tych samych dokumentach. Zanim poprawisz kod, wyjaśnij jednostkę i mianownik.
Sam test wykonany przed operacją nie gwarantuje, że dane pozostaną takie same do chwili użycia. Powiąż odbiór z wersją wejścia i sprawdź rzeczywisty wynik działania. Unikaj alternatywnych ścieżek, które omijają kontrolę. Błąd walidatora powinien dawać jawny brak odbioru, nie automatyczne „wszystko dobrze”.
07 / Co przekazać człowiekowi
Zamiast samego zielonego znaku pokaż: co sprawdzono, według której reguły, na jakiej wersji danych oraz czego nie sprawdzono. Do rekordu liczbowego dołącz dowód pomiaru, zakres czasu i sposób liczenia. Dla cytatu potrzebne będzie odniesienie do źródłowego fragmentu, nie tylko zgodność formatu.
Drugi model może znaleźć rozbieżność i pomóc w przeglądzie. Jego zgoda nie zmienia się jednak w niezależny dowód prawdy ani ludzkie zatwierdzenie. Osoba odbierająca musi mieć możliwość sprawdzenia materiału, odrzucenia go i zapisania przyczyny. Samo umieszczenie człowieka na końcu procesu nie dowodzi jakości nadzoru.
Jeśli chcesz zastosować tę metodę u siebie, zacznij od jednego raportu i trzech warunków, które dziś sprawdzasz ręcznie. W rozmowie możemy oddzielić reguły do zakodowania od pytań wymagających źródła i osądu. Nie trzeba na początek ujawniać prywatnych danych — wystarczy neutralny przykład problemu.
08 / Źródła, pochodzenie i korekty
Punktem wyjścia była pełna wewnętrzna bibliografia z 21 czerwca 2026 r. Ponownie sprawdzono opisy trzech wskazanych prac w źródłach autorów i wydawców 25 września 2026 r. Nie powtarzamy deklaracji o wcześniejszej niezależnej weryfikacji jako wykonanej w tym wydaniu. Nie przenosimy tez prawnych ani historycznej deklaracji działania konkretnego zabezpieczenia do opisu obecnej produkcji.
Tekst PL/EN, autorski diagram i kod demonstracji przygotował Codex. Przeprowadzono odbiór autorski oraz opisane siedem testów, bez niezależnej recenzji drugiego modelu. Nie wykorzystano cudzych ilustracji ani prywatnych danych. Zmiana znaczenia pól, wykryty błąd walidatora lub istotna korekta przywołanej pracy uruchamia ponowny przegląd. Materiał można wycofać po publikacji.